
Blog · 18 Kasım 2026 · 5 dk okuma
Üç yapay zekâ araştırma aracına aynı soruyu sorduk. İşte gelen sonuçlar
"Derin araştırma" artık neredeyse her yapay zekâ asistanının ürün adında geçiyor. Raporlar ilk bakışta birbirine benziyor: başlıklar, paragraflar, sonda bir link listesi. Farklar ancak içlerinde gerçekte ne olduğunu saydığınızda ortaya çıkıyor. Biz de saydık.
Nasıl karşılaştırdık
- FindDepth, Gemini 4 Argon ve ChatGPT 6 Deep Research'e aynı soruları, İngilizce olarak, Ekim 2026'da sorduk.
- Her raporu teslim edildiği gibi, düzenlemeden sakladık; kelime, tablo, metin içi atıf ve listelenen kaynakları teslim edilen dosyalardan kendimiz saydık.
- "Kontrol edilen rakamlar" FindDepth'in kendi otomatik kontrolüdür: rapordaki her rakam, atıf yapılan kaynağın metninde aranır. Diğer araçlar böyle bir kontrol raporlamıyor; tahmin yürütmek yerine "raporlanmadı" yazıyoruz.
Farklı konularda iki soru sorduk. Sonuçlar soruya ve denemeye göre değişir; raporları okuyup kendiniz karar verin. Altısının da linki karşılaştırma sayfasında.
Soru 1: Birinci ve İkinci Dünya Savaşı küresel düzeni nasıl değiştirdi?
| FindDepth | Gemini 4 Argon | ChatGPT 6 Deep Research | |
|---|---|---|---|
| Rapor uzunluğu | ≈16.700 kelime | ≈5.600 kelime | ≈8.000 kelime |
| Okunan kaynak | 52 | Raporlanmadı | Raporlanmadı |
| Atıf yapılan kaynak | 21 | 41 | 37 |
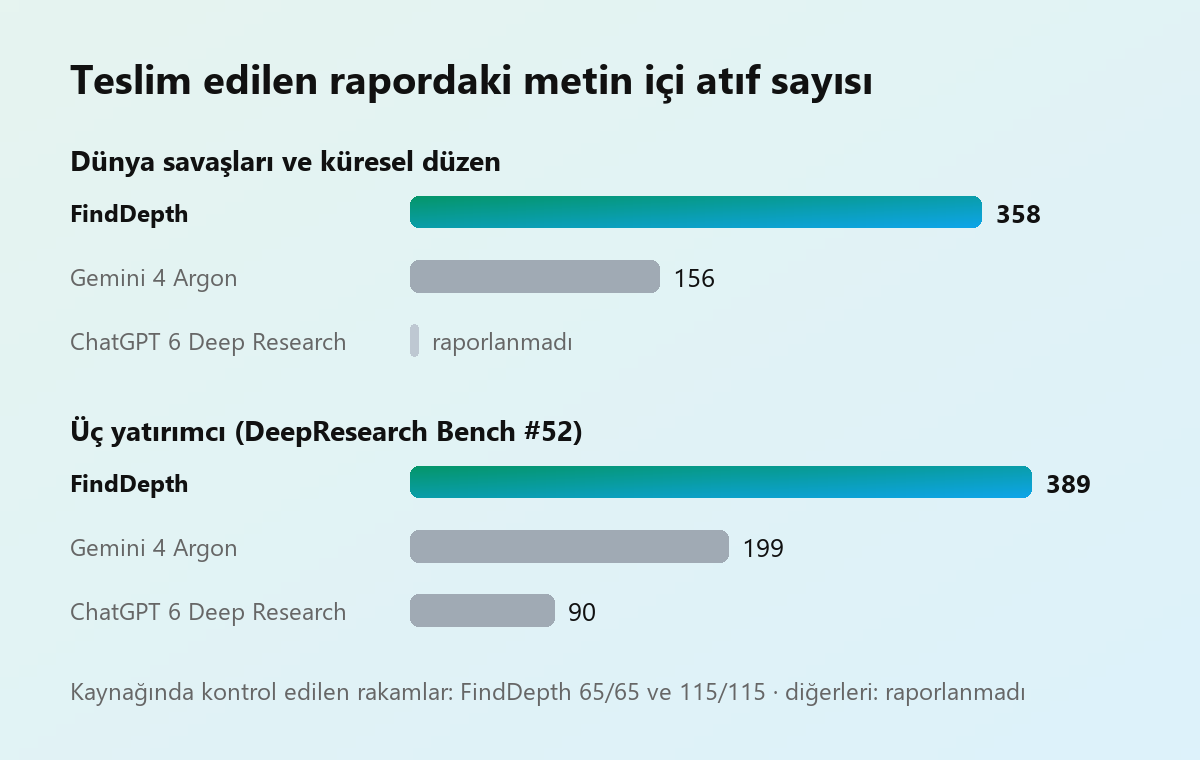
| Metin içi atıf | 358 | 156 | Raporlanmadı |
| Tablo | 9 | 2 | 2 |
| Kaynağında kontrol edilen rakam | 65'in 65'i bulundu | Raporlanmadı | Raporlanmadı |
| Belirtilen açık soru | 5 | Belirtilmedi | Belirtilmedi |
Soru 2: Duan Yongping, Warren Buffett ve Charlie Munger'ın yatırım felsefeleri nelerdir?
Bu, herkese açık bir test seti olan DeepResearch Bench'in 52. sorusu. Kendimiz seçmedik, listedeki sırasıyla aldık.
| FindDepth | Gemini 4 Argon | ChatGPT 6 Deep Research | |
|---|---|---|---|
| Rapor uzunluğu | ≈14.600 kelime | ≈6.500 kelime | ≈7.900 kelime |
| Okunan kaynak | 56 | Raporlanmadı | Raporlanmadı |
| Atıf yapılan kaynak | 14 | 32 | 29 |
| Metin içi atıf | 389 | 199 | 90 |
| Tablo | 8 | 3 | 1 |
| Kaynağında kontrol edilen rakam | 115'in 115'i bulundu | Raporlanmadı | Raporlanmadı |
| Belirtilen açık soru | 4 | Belirtilmedi | Belirtilmedi |
Rakamlar ne anlama geliyor, ne anlama gelmiyor
Uzun olmak otomatik olarak daha iyi demek değil. 16.000 kelimelik bir rapor ancak fazladan uzunluk kanıt taşıyorsa işe yarar. Biz yoğunluğa baktık: bir cümle ne sıklıkla açabileceğiniz bir kaynağa bağlanıyor. İki soruda da FindDepth en yakın araca göre yaklaşık iki kat ya da daha fazla metin içi atıf yaptı.
Kaynaklar sadece listelenmiyor, baştan sona okunuyor. FindDepth 52 ve 56 kaynağı baştan sona okudu ve metni gerçekten destekleyenleri tuttu. Sondaki uzun bir kaynakça, her kaynağın ne kadar dikkatli kullanıldığı hakkında pek bir şey söylemez; metin içi atıflar bunu doğrudan gösterir ve FindDepth tam burada önde.
Kontrol edilen rakamlar. İki FindDepth raporundaki her rakam, atıf yaptığı kaynağın metninde bulundu: 65'te 65 ve 115'te 115 (FindDepth'in otomatik kontrolü). Diğer araçlar rakamlarının kontrol edilip edilmediğini göstermiyor. FindDepth gösteriyor. Rakamlar kararınız için önemliyse, asıl fark budur.
Hız mı, güven mi? Tipik bir FindDepth araştırması 20–50 dakika sürer, çünkü raporu görmeden önce her kaynak baştan sona okunur ve her rakam kontrol edilir. Hızlı araçlar kısa bir genel bakış için yeterlidir. Güvenebileceğiniz bir rapor gerektiğinde fark tam olarak budur.
Kendi sorunuzda deneyin
En adil test, sizin için önemli olan testtir. Aynı soruyu kullandığınız araçlara ve FindDepth'e sorun, sonra her rapora 10 dakikalık kontrolü uygulayın.
Gemini ve ChatGPT sahiplerinin ticari markalarıdır. FindDepth bağımsızdır ve onlarla bağlantılı değildir.